
Google показала автономное дообучение моделей с Tunix
11 сентября Google Developers опубликовал эксперимент с автономным постобучением языковых моделей. В нём агент получает правила работы, меняет один учебный скрипт, запускает обучение на TPU, читает итоговую метрику и решает, сохранить изменение или вернуть предыдущую версию. Это не новая модель и не сервис с кнопкой «улучшить ИИ». Перед нами инженерный контур, который автоматизирует перебор гипотез, сохраняя измеримый результат и историю неудач.
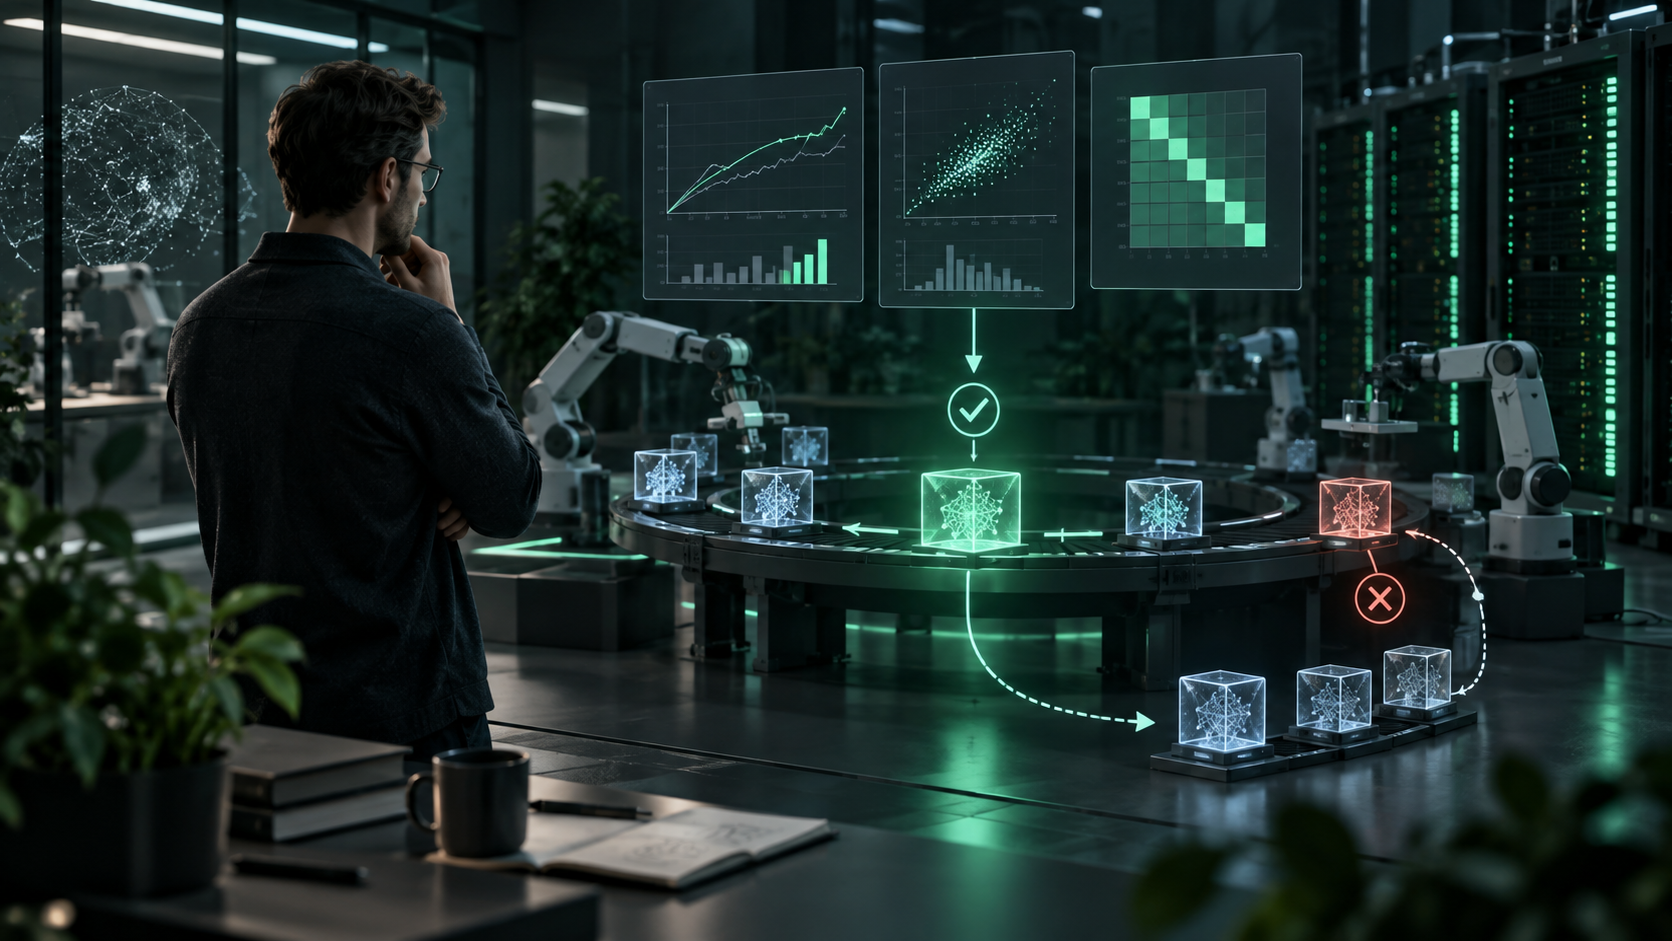
Иллюстрация AI-редакции: автоматический цикл предлагает и проверяет варианты, а критерий качества и границы задаёт человек.
Как устроен эксперимент
В основу вошли Tunix, модели Gemma и облачные TPU. Агент работает через Antigravity CLI с Gemini Flash 3.7. В файле program.md исследователь описывает цель, доступные команды, лимит времени и правила сравнения. Агент может редактировать только run.py, запускать его, получать метрику и записывать результат в results.tsv. Удачное изменение фиксируется коммитом, неудачное откатывается. Поэтому история не растворяется в диалоге: видно, какой код дал каждый показатель.
Google проверила два сценария. В первом FunctionGemma 270M дообучали для действий в мобильном интерфейсе. На одном TPU v5e агент провёл двадцать прогонов за несколько часов. Во втором Gemma 3 1B обучали с подкреплением на задачах GSM8K. Сорок экспериментов на TPU v6e заняли два–три дня и улучшили выбранную авторами метрику примерно на десять процентов. Это результаты конкретных конфигураций, а не гарантия такого же прироста на любых данных.
Что здесь действительно новое
Автоматический подбор гиперпараметров существует давно. Отличие показанного подхода — в свободе изменять сам учебный код в пределах песочницы. Агент может поменять функцию потерь, расписание скорости обучения, обработку данных или стратегию оценки, затем немедленно проверить гипотезу. Получается цикл «прочитал состояние — предложил изменение — запустил — измерил — сохранил или отменил».
Свобода одновременно создаёт риск. Если метрика плохо описывает реальную задачу, агент научится улучшать именно число. Он может случайно использовать тестовые данные при обучении, удалить дорогую проверку или найти короткий путь, который выглядит победой только внутри стенда. Поэтому перед запуском нужна контрольная выборка и независимая проверка, а не одна итоговая строка.
Почему журнал важнее красивого финала
Обычный исследовательский блокнот часто хранит только удачный вариант. Автономный цикл генерирует десятки почти одинаковых попыток, и без строгого журнала их невозможно восстановить. Для каждого прогона нужны версия кода, исходные веса, набор данных, seed, продолжительность, расходы, метрики по отдельным группам и причина принятия. Отдельно сохраняются ошибки и превышения лимита.
Коммит сам по себе недостаточен: внешняя библиотека или образ окружения способны измениться. Воспроизводимый пакет включает lock-файл, хеш данных, конфигурацию оборудования и точную команду запуска. Этот принцип совпадает с правилами смены рабочей модели: изменяем одну переменную, сравниваем на прежнем наборе и заранее готовим откат.
Как провести безопасный пилот
Начните не с дорогой большой модели, а с задачи, которую можно прогнать за десять–тридцать минут. Разделите данные на обучающую, валидационную и закрытую контрольную части. Агенту показывают только первую метрику; закрытый набор проверяет человек после завершения серии. Запретите сетевой доступ, кроме необходимых хранилищ, и не передавайте секреты в текст задания.
Затем ограничьте поверхность изменений. На первом цикле разрешите менять три–пять параметров или одну функцию, а не весь репозиторий. Установите потолок запусков, времени и стоимости. Завершение по бюджету должно срабатывать технически, даже если процесс считает следующую гипотезу перспективной. Для каждой критической ошибки задайте немедленную остановку.
Наконец, повторите лучший вариант с нуля несколько раз. Один высокий результат может быть случайностью. Сравните среднее и разброс, проверьте редкие классы и откройте примеры, где качество ухудшилось. Если прирост исчезает после честного повторения, победного эксперимента не было.
Кому подход полезен сейчас
Автономный цикл оправдан командам, у которых уже есть стабильный тренировочный pipeline, автоматическая оценка и дешёвые короткие прогоны. Он помогает ночью перебирать гипотезы и утром отдавать исследователю журнал, а не набор обещаний. Для проекта без чистых данных и метрики агент лишь ускорит производство невоспроизводимых вариантов.
Это также не замена fine-tuning как инженерному процессу. До автоматизации нужно понять, зачем дообучение лучше RAG, правил или нескольких примеров в запросе. Маленькая модель для одного действия может быть разумной целью; универсальный помощник «для всего» плохо поддаётся такой проверке.
Вывод редакции
Опыт Google интересен не тем, что модель якобы обучает себя без людей, а дисциплиной цикла: узкий файл, измеримая цель, ограниченный бюджет, коммит победителя и откат проигравшего. Исследователь остаётся владельцем данных, метрики и допуска в продукт. Если эти три вещи не определены, автономность лишь быстрее доведёт эксперимент до неправильного ответа.
Частые вопросы
Tunix — это готовый автоматический тренер? Нет. Это библиотека постобучения, а автономный цикл собирается из неё, агента, вычислений и правил конкретного проекта.
Можно ли доверять улучшению на десять процентов? Только в рамках описанного опыта. Для другого набора и метрики результат нужно воспроизвести независимо.
Что нельзя отдавать агенту? Закрытый контрольный набор, неограниченный бюджет, производственные секреты и право принять модель без человеческой проверки.