LightOnOCR-3-4B: распознавание страницы вместе с её структурой
8 октября команда LightOn представила семейство LightOnOCR-3. В нём три размера: 0,8, 1 и 4 миллиарда параметров. Для подробной карточки мы взяли LightOnOCR-3-4B, потому что этот вариант показывает, как распознавание текста можно соединить с картой страницы. Но «4B» не означает готовую бухгалтерскую проверку или универсальное понимание любого PDF. Модель возвращает черновое представление документа, а проверять значения и смысл по оригиналу всё равно должен человек или отдельный контрольный процесс.
Два режима одного инструмента
Если передать изображение страницы с пустым текстовым запросом, семейство работает как OCR: пытается восстановить текст. Если подать единственное слово grounding, ответ дополнительно содержит координаты и типы блоков. Разработчики описывают подписи к изображениям и данные графиков в виде таблиц. Координаты нормализованы в диапазон от 0 до 1000. Это удобно, когда нужно не просто получить длинную строку, а знать, из какой области страницы взялась цифра или заголовок.
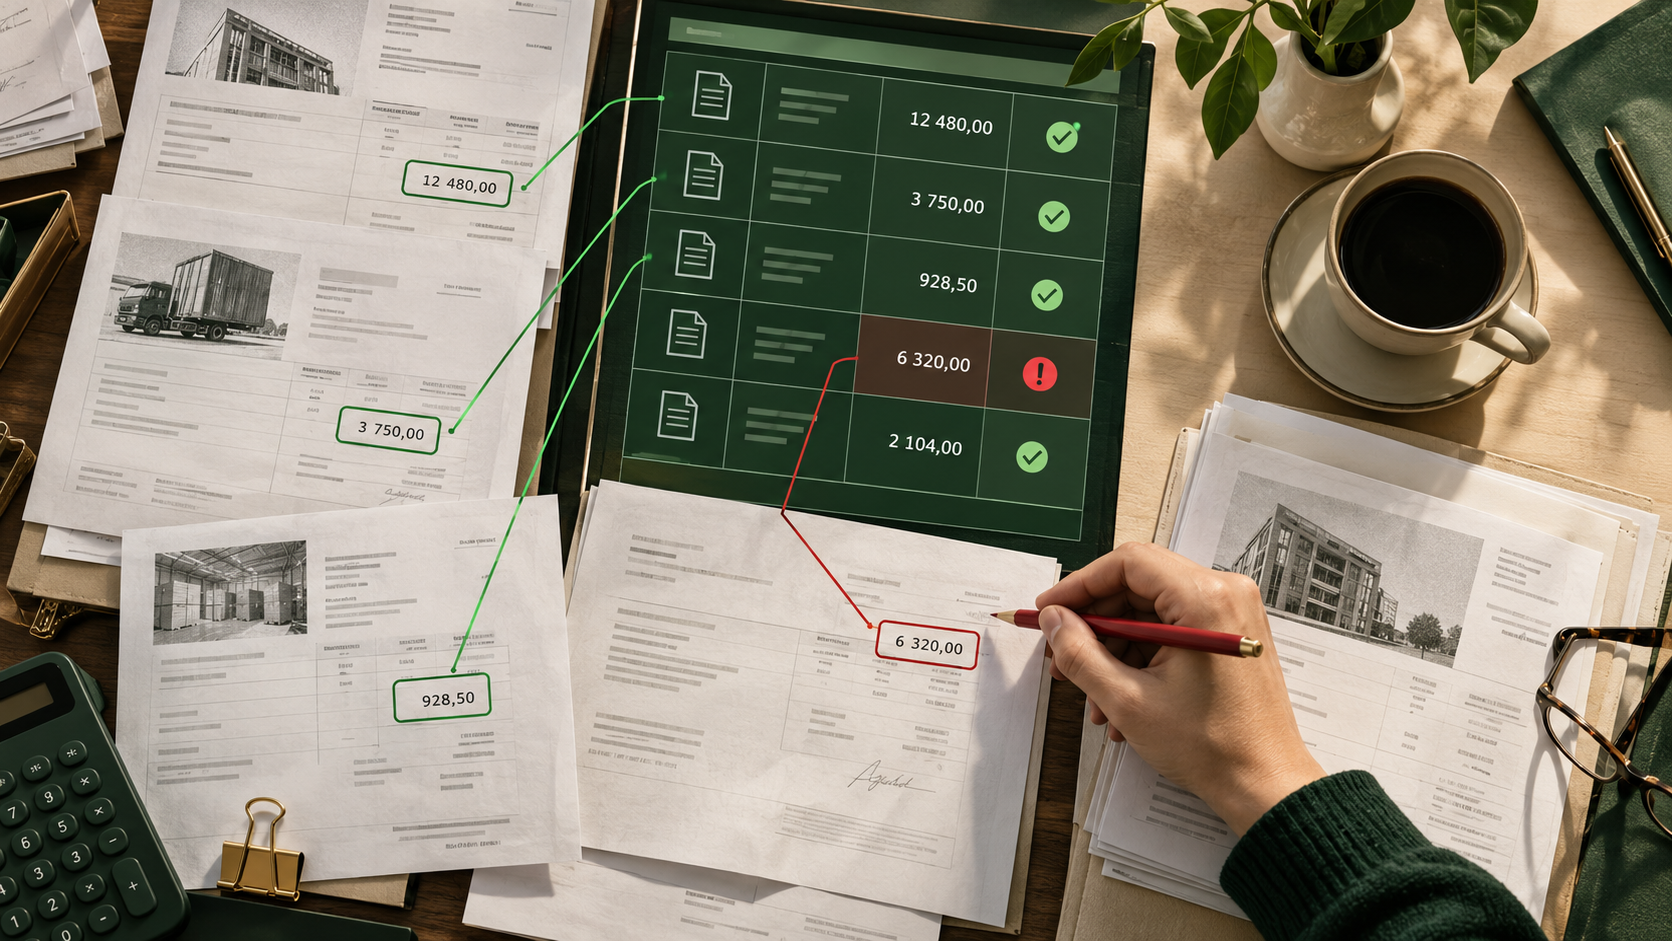
Представьте акт с таблицей в центре и сноской мелким шрифтом внизу. Обычное распознавание может выдать весь текст подряд. Структурный режим помогает привязать фрагмент к области листа и показать оператору исходный прямоугольник. Однако разметка блока не доказывает правильность распознанной суммы. Запятая, минус или единица измерения могут потеряться. Важные поля всё равно нужно открывать рядом с изображением. Мы отдельно собрали практический порядок сверки чисел после OCR.
Что действительно открыто
Авторы выпустили веса под Apache 2.0 и опубликовали сопутствующий репозиторий с преобразованием результата и скриптами визуализации. Это делает локальное испытание возможным без отправки каждой страницы во внешний API, если инфраструктура и зависимости настроены правильно. Но лицензию модели нельзя автоматически распространять на сторонние библиотеки, входные документы и конечный продукт. Проверьте лицензии всего стека, условия ваших договоров и место хранения файлов. Локальный запуск полезен для приватности только тогда, когда сама система не отправляет журналы, изображения или диагностические данные наружу без вашего ведома.
В официальном материале разработчики сравнивают свои модели с открытыми конкурентами на наборах распознавания документов. Эти результаты — авторское измерение на известных датасетах. Не следует из них выводить гарантированный процент точности на русских печатях, рукописных пометках, чертежах или плохих мобильных снимках. Сложный документ может выглядеть узнаваемо, но ошибка в одной строке таблицы сделает весь расчёт бесполезным. Испытание нужно строить по собственным типам страниц.
Как подготовить контрольный набор
Соберите не десять красивых сканов, а 50–100 страниц разных типов: чистый цифровой PDF, фото под углом, многостолбцовый отчёт, таблица со сносками, письмо с подписью, страница с графиком. Уберите или замаскируйте персональные сведения там, где это возможно. Для каждой страницы вручную укажите несколько критичных полей: сумма, дата, номер документа, единица измерения, заголовок таблицы. Отдельно пометьте страницы, где правильный ответ — «прочитать невозможно».
Прогоните простой текстовый режим и grounding на одной и той же выборке. Сравните не длину красивого Markdown, а точность обязательных полей, правильность их расположения, число пропущенных сносок и время ручной проверки. Если у модели есть таблица графика, сравните её с осью и легендой на исходнике. Если таблица восстановлена с ошибкой, классифицируйте причину: плохое изображение, неправильное чтение чисел или нарушенная связь строки со столбцом. Эти ошибки исправляются разными способами. Обзор Docling как конвейера подготовки PDF поможет понять, когда достаточно иной конструкции без этой модели.
Где проходить границу автоматизации
Хорошее применение — предварительно разложить архив по полям и показать сотруднику фрагменты, которые требуют внимания. Рискованное — автоматически переносить найденную сумму в платёж или отклонять документ только на основании OCR. Для последнего нужны формальные правила, независимая сверка и журнал исправлений. Человек должен видеть не только извлечённый текст, но и область исходного скана. Иначе ошибка будет красиво оформлена и потому менее заметна.
Семейство предлагает три размера не ради одного «победителя». Маленький вариант может быть достаточно быстрым для предварительного поиска, а большой — оправданным на трудных страницах. Сделайте маршрутизацию: сначала дешёвый проход, затем ручная очередь для неуверенных и критичных случаев. Не доверяйте внутренней уверенности модели как точному вероятностному прогнозу без калибровки. При обновлении версии прогоните прежние трудные страницы снова: новый средний балл иногда скрывает ухудшение на редком, но важном формате.
Частые вопросы
Можно ли использовать модель коммерчески?
Разработчики указали лицензию Apache 2.0 для весов. Но коммерческий проект должен отдельно проверить зависимости, входные данные и условия собственного использования.
Grounding гарантирует правильное чтение таблицы?
Нет. Он добавляет структуру и координаты, но цифры, подписи осей и связь строк нужно проверять на оригинале.
Какой вариант выбрать: 0,8B, 1B или 4B?
Измерьте качество и время на своих страницах. Размер сам по себе не гарантирует лучшего результата в вашем языке и формате.